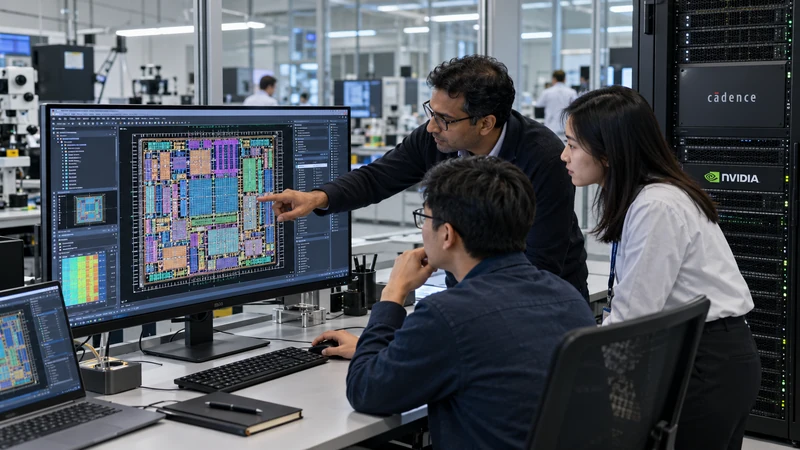
Cadence Design Systems ha presentato il 26 ottobre Maestro, una famiglia di modelli di intelligenza artificiale specializzati nella progettazione di chip e sistemi. La novità più concreta è la possibilità di eseguirli nel cloud Cadence, su cloud pubblici o interamente nei data center del cliente.
Per un settore in cui file, architetture e dati di produzione valgono anni di ricerca, mantenere il modello dietro il proprio firewall può contare quanto la sua precisione.
Maestro collega i modelli agli strumenti EDA e SDA usati dagli ingegneri per verificare circuiti, consumo, tempi e disposizione di miliardi di transistor. Gli agenti possono proporre o eseguire passaggi del flusso, ricevere un risultato dagli strumenti e migliorare attraverso cicli di apprendimento per rinforzo.
Non sostituiscono il software di progettazione: lo utilizzano come ambiente controllato nel quale le ipotesi vengono misurate invece di restare semplici risposte testuali.
Una parte della tecnologia si basa su Nemotron di Nvidia e utilizza OpenShell per limitare le azioni degli agenti. Cadence dichiara un’architettura aperta a modelli proprietari e open-weight, così che il cliente possa scegliere in base a prestazioni, costo e sicurezza.
Questo approccio si distingue dall’accordo con cui Synopsys svilupperà GPT-Synopsys insieme a OpenAI su infrastruttura ospitata dal laboratorio statunitense.
Nei primi flussi analizzati, Cadence indica fino al 30% di qualità in più e fino a cinque volte maggiore efficienza nell’uso dei token rispetto a modelli generalisti. Sono risultati comunicati dall’azienda, non una misura universale: dipendono dal compito, dal progetto e dal confronto scelto. Il dato utile è la direzione.
Un modello piccolo e addestrato sul dominio può essere più economico di uno molto grande quando deve usare strumenti tecnici con regole definite.
L’esecuzione interna risponde a un problema specifico delle imprese di semiconduttori. Caricare progetti non annunciati in un servizio esterno può violare accordi, controlli sulle esportazioni o politiche di proprietà intellettuale. Tenere pesi, dati e log nel perimetro aziendale riduce l’esposizione, ma non elimina i rischi.
Servono gestione degli accessi, registrazione delle azioni, separazione dei progetti e verifiche umane prima che una proposta dell’agente entri nel disegno finale.
Per i progettisti, il guadagno potenziale non è creare un chip con una richiesta in linguaggio naturale. È ridurre iterazioni ripetitive: lanciare verifiche, confrontare configurazioni, cercare errori e ottimizzare parametri. Anche un miglioramento modesto su migliaia di passaggi può abbreviare il tempo di sviluppo.
Restano attività in cui il giudizio umano domina, soprattutto quando costi, affidabilità e compromessi non sono catturati da un singolo punteggio.
L’accesso iniziale è previsto nel quarto trimestre per clienti selezionati. Prima di parlare di adozione ampia serviranno risultati su progetti reali, compatibilità con flussi esistenti e costi di gestione on-premise. Un modello interno richiede hardware, aggiornamenti e personale; il cloud è più semplice da avviare, ma offre meno controllo.
Maestro prova a evitare questa scelta rigida offrendo una stessa famiglia in ambienti diversi.
Per l’Europa la possibilità di mantenere dati e calcolo in azienda può facilitare l’uso dell’IA in filiere sensibili, comprese automotive, difesa e componentistica industriale. Non risolve da sola gli obblighi normativi né la dipendenza da hardware americano.
Offre però un modello pratico: l’IA specializzata diventa una parte dello strumento di ingegneria, controllata e misurata nel luogo in cui nasce il progetto.